高通量测序服务:从数据产能到科研结论的完整链路
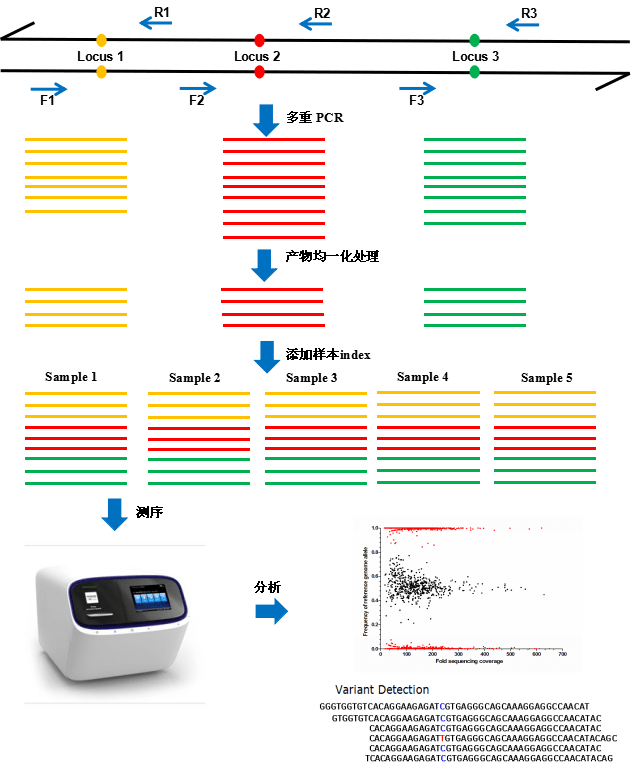
过去十年,测序成本的下降速度超过了半导体行业的摩尔定律。据美国国立人类基因组研究所(NHGRI)的长期追踪数据,完成一个人类全基因组的测序费用已从2001年的近1亿美元降至如今的数百美元量级;而单Gb碱基的测序成本,在NovaSeq X Plus、DNBSEQ-T7等高通量平台上已跌破1美元。成本曲线的陡降,把矛盾从"测不测得起"转移到了"测完之后怎么办"。这正是高通量测序服务的核心价值所在——它不只是把样本送上机器,而是把一份生物样本转换成可发表、可复现的科研结论。
产能之外:平台选型决定数据质量边界
目前主流的二代测序平台在通量与读长上呈现明显分层。以Illumina NovaSeq X Plus为例,双流动槽模式下单次运行可产出约26 Tb数据,折合人全基因组(30×覆盖度)近百例;华大智造DNBSEQ-T7则以日产6 Tb左右的数据量支撑大规模队列研究。选择哪一类平台,取决于研究目标而非单纯的"数据量":
- 全基因组测序(WGS):关注结构变异、拷贝数变异或罕见病位点,需要30×以上的深度与较长的插入片段文库;
- 转录组测序(RNA-seq):更看重链特异性建库与生物学重复数量,单样本数据量通常在6 Gb上下即可满足差异表达分析;
- 扩增子测序:16S/18S/ITS等标记基因扩增,通量需求低但要求引物区无偏好性扩增;
- 单细胞测序:细胞捕获效率与双细胞率是比测序深度更关键的质控指标。
把平台参数与生物学问题对齐,是科研测序外包中最容易出错、也最值得投入精力的一步。
样本到文库:被低估的中间环节
在实际项目中,导致数据失败的往往不是测序仪,而是上游样本。RIN值低于6的RNA样本、降解严重的FFPE组织、含有大量宿主DNA的环境样本,都会在文库构建阶段放大偏差。一套成熟的高通量测序服务流程,通常包含核酸提取质控、文库片段分布检测(如Agilent 2100或Qsep系统)、上机前的qPCR定量,以及下机后的Q30比例与重复率评估。以人全基因组为例,Q30通常要求不低于85%,样本间污染率控制在1%以内,才能保证后续变异检出的假阳性率处于可接受区间。
测序数据分析:从FASTQ到可解释的结论
一次30×人全基因组产生的原始数据约90–100 GB,若叠加多组学队列,原始数据量可轻松达到TB级别。数据本身不构成结论,生物信息学分析才是增值环节。标准化的分析链路一般包括:
- 质控与去接头(fastp、Trimmomatic);
- 比对与去重(BWA-MEM、GATK最佳实践流程);
- 变异注释与致病性判读(VEP、ClinVar、gnomAD数据库比对);
- 下游统计与可视化(差异分析、富集分析、KEGG/GO通路映射)。
值得注意的是,分析结果的可复现性正成为期刊审稿的关注点。保留完整参数日志、版本信息与分析脚本,其重要性不亚于实验部分的方法学描述。
价格之外,如何评估一家测序服务商
基因检测价格是科研采购中最直观的指标,但并非唯一指标。单看每Gb单价,不同服务商的报价差异可能高达数倍,其中往往隐藏着数据量定义(raw data还是clean data)、Q30阈值、是否包含生信分析等变量。对于以杭州基因测序市场为代表的区域性科研外包需求,更应关注三点:一是样本接收与返样流程是否规范;二是生信团队是否具备对应物种或研究领域的分析经验;三是数据交付格式是否支持后续自主再分析。
随着长读长测序、空间转录组等技术的成熟,高通量测序服务的边界仍在扩展。对科研团队而言,把测序当作一次"采购"还是当作一段"合作",将直接决定数据能走多远。